
Essay2026 / 09 / 20
xv6实验3-页表与内存管理
0-知识预备
0.1-地址映射
在计算机系统上,CPU等硬件向使用者提供了一层抽象,即 物理地址空间。这里的物理地址空间实际上并不只是内存,而是硬件为了使用者方便而做的抽象。如硬件层面读写物理地址0x200000可能能够读取时钟周期,读取0x400000则是能够与磁盘数据进行交互,读取0x800000以上则是能够与内存(RAM)进行交互执行读写操作。但是历史上已经说明直接使用物理地址是不可靠,难用的。
因为对于上层的软件编写只想要的是一块纯净的,从0开始的,无限大小的地址区域(图灵机),所以虚拟地址空间便来了
每个进程都有自己所看到的那个虚拟地址,而自己的虚拟地址将会映射到物理地址上。
从数学层面来说,虚拟地址与物理地址之间存在一个映射关系。其中每一个虚拟地址VA将映射到一个物理地址PA
0.2-映射到页表
而VA与PA之间存在映射关系。
那么f理论可以有多种形式
又或者(单级页表)
又或者(多级页表)
而这些式子需要被 存储 ,然后在进行地址翻译时调用。 而页表就是这样的式子在工程实践上的实现。因为其设计满足计算机偏好的局部性原理,在翻译上能够达到高效。
0.3-页表与地址翻译
页表实现的是刚才我们所说的式子2的映射。 其中这里有一个关键的概念,即为 页(page) 页是内存管理/虚拟内存映射的一个单位。页的大小控制着页表的大小。
- 页越大页表越小,但是内存管理粒度更粗
- 页越小页表越大,但是内存管理粒度更细
本处xv6规定页大小为4096字节。 而页表就是一个结构体数组。每一项存储着PPN与falg信息。 其中关于单级页表/多级页表,以及硬件如何支持加速地址翻译论述详见 CSAPP-虚拟内存
其中整个地址翻译过程大致如下
- VA被拆分为低位的VPO(Vitural Page Offset)与VPN(Vitural Page Number)
- VPN在页表中索引,中间会有一套复杂的机制,得到相应表项,读取flag进行权限判断等,最后可能会返回物理地址高位的PPN(Pyhsical Page Number)
- PPN与VPO进行拼接得到PA
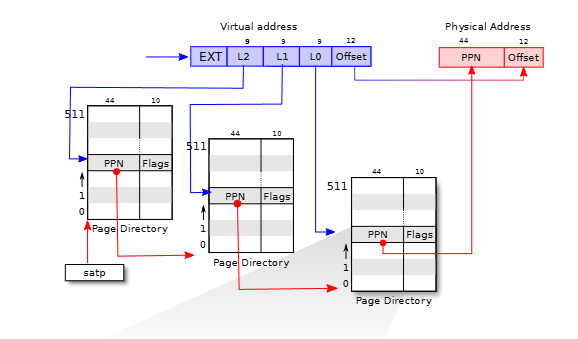
其中在xv6所工作的平台上。
- 64位的VA只有低39位被使用(意味着虚拟内存最大容量为512GB)。其中这39位,低12位为VPO,高27位为VPN
- 物理地址为56位,其中低12位为PPO,高44位为PPN
- 页表将会存储VPN到PPN之间的映射关系。其中这个页表采取3级页表的结构。L2,L1,L0均为9位长度。
0.4-内核内存空间
内核的内存空间如下
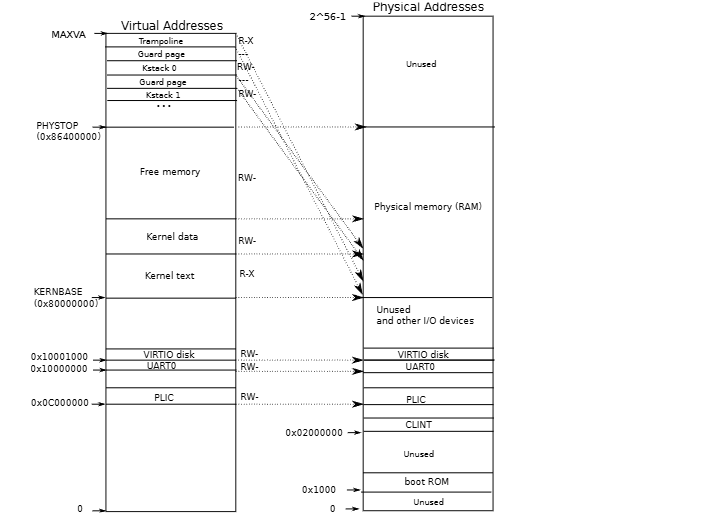
在左侧的物理地址空间即硬件提供的抽象。他们提供了这样的硬件层面的地址空间。对某些区域的读写实际上就是控制相应的硬件,而某些区域则是对于内存的读取写入。
右侧的虚拟地址空间则是硬件划定大小,而操作系统决定如何使用划分区域的地址空间。xv6的代码则是将会维护相应的映射关系与这块虚拟地址空间的划分使用。
从低地址往上依次解析.其中在KERBASE(0x80000000)往下的地址空间属于硬件提供给软件的接口。这样软件能够通过统一的物理地址空间这个抽象来与不同的硬件之间交互。(注:访问这里的设备不一定走DRAM,而是可能直接与硬件寄存器通信)
在KERBASE往上就是硬件提供给软件去使用的物理地址空间。这里也是操作系统去管理,使用的区域。其中KERNEL让VA当中KERNBASE到PHYSTOP之间的地址与物理地址上直接映射。这样内核具有访问任意物理内存的控制。
在KERBASE以下的为
- boot ROM ,Soc内部的一小块只读存储器,出场时即写好。CPU 一上电复位,就从这里开始执行。
- PLIC(Programmable interrupt controller),管理外部中断,比如 UART、磁盘的中断信号,告诉 CPU 该处理哪个中断。
- UART0,串口控制器,xv6 的 console 输入输出
- VIRTIO disk,QEMU 提供的虚拟磁盘设备,xv6 的文件系统存在这上面。
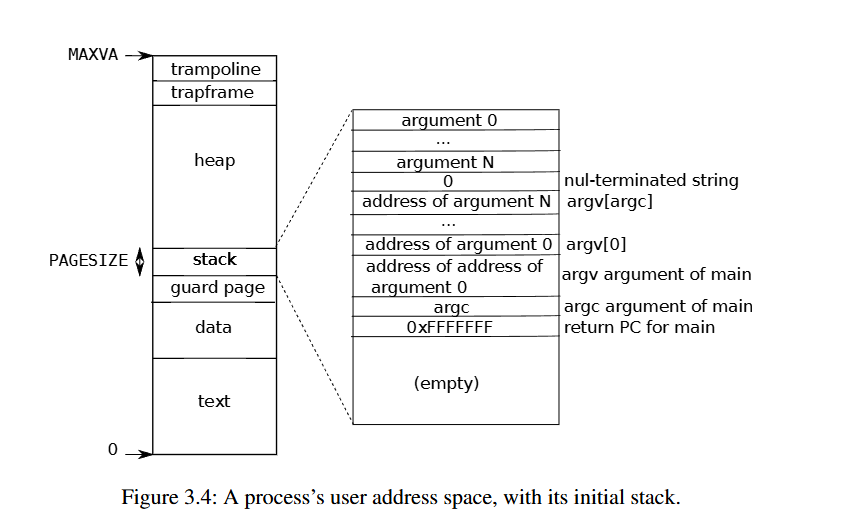
在KERNEL的虚拟地址空间分布上还有与用户进行交互的部分
- kstack 进程的内核栈。一个进程两个栈的内核栈。内核函数的执行将会使用这个内核栈
- Guard Page 专门没有映射到物理内存上的虚拟页,用以内核栈溢出时触发缺页异常来起到隔离保护作用
- trampoline 跳板页,一小段汇编代码,保存用户寄存器到 TRAPFRAME,切换到内核页表,跳到内核 C 代码;返回时再反向操作。
0.5-用户内存空间
0.6-内存管理与系统工程
操作系统对物理内存进行管理。他将每次分配或释放一个PAGESIZE的物理内存。并且其会维护一个freelist记录所有空闲的物理内存页。所以操作系统在
kernel/kalloc.c内实现了对于物理内存区域的获得,释放接口
而在kernel/vm.c内实现了对于虚拟内存的创建uvmcreate,申请uvmalloc,释放uvmdealloc,销毁uvmfree。以及不动物理内存区域释放,仅操作页表内VA映射的mappages,uvmunmap
而具体对于内存的管理方式分散在操作系统的其他功能模块如进程,文件系统等等的合理使用。他们将调用这里的接口功能以达成如内存布局控制,内存何时释放,申请等等。

以进程的创建allocproc为例。
- 在进程表内寻找可用的进程。
- 此时开始补齐进程的各类信息。首先就是申请pid
- 为预先在VA space上定义好的trapframe使用kalloc申请一块物理内存区域
- 调用
proc_pagetable创建进程页表。其中这个函数不只是使用uvmcreate申请到页表就返回。而是会给如trapframe等预定义VA区域与申请到的物理内存页之间建立映射,记录到页表上。即这个函数也有相应初始化功能 - 设置进程的上下文等内容
1-加速系统调用
一般而言操作系统会在用户与内核之间建立一个二者均可访问的缓冲区。此时用户的一些系统调用可直接读取缓冲区内容而无需进入内核
这里我们将实现一个ugetpid,并使用这样的缓冲区。
1.1-分析
所以我们需要明确这个缓冲区是被用户与内核之间共享的。那么在内存上,用户进程的VA space要有这么一块区域访问到这块物理内存,同时进程的VA space也又要有这么一块区域能够访问到这块物理内存。 其中每个进程在物理内存上都将有自己的这么一个缓冲区。 这个缓冲区我们记为USYSCALL。
USYSCALL与TRAPFRAME同构

当一切都完成时,用户的系统调用只需要通过访问VA space中的USYSCALL去访问即可。而对于kernel,其通过访问proc内相应的属性usyscall便可找到对应的物理内存区域,进行缓冲区的数据更新。
1.2-接口添加
所以在实现之前,先让这个东西在用户接口这里占个坑吧。
在user/user.h的ulib部分添加
int ugetpid(void);这里不需要去同步修改user/usys.pl,kernel/syscall.c,kernel/syscall.h等的原因为我们的这个函数本身的实现直接在用户侧。按照项目架构,其实现将会写在user/ulib.c
1.3-内存布局
由于USYSCALL作为一个VA中固定访问的页。所以我们给USYSCALL有这规则是适合的。
- USYSCALL位于一个固定的VA上,与TRAPFRAM类似.使得用户态程序可以通过直接访问
USYSCALL来读取缓冲区内容 - USYSCALL的大小即为
one page - USYSCALL这块物理内存区域需要允许用户,并且对用户只开放读权限
所以同步地来说说要对哪些文件修改,以及他们的作用。
修改kernel/memlayout.h.该文件为虚拟地址空间的全局布局(对于kernel,user)区域的定义。其他功能模块可以直接使用这里定义规划好的区域划定自己的虚拟地址空间,然后申请物理内存( kernel/kalloc.c ),页表建立映射关系( kernel/vm.c )。让USYSCALL占用TRAPFRAME下的一个page即可。这样做是可行的,(回看本文0.4节,0.5节)
#define USYSCALL (TRAPFRAME-PGSIZE)
struct usyscall{
    int pid;
};
1.4-用户态VA space
所以USYSCALL将只会出现在用户态的VA space下。而内核的VA space无需这么做,因为内核后续要通过缓冲区与用户态进程交互时,可以通过读取proc p->usyscall来直接访问。
所以第一个点,就是将usyscall指针作为proc的一个属性。
这需要在kernel/proc.h内进行添加
// Per-process state
struct proc {
    //......

    //// these are private to the process, so p->lock need not be held.
    struct usyscall *usyscall;
}随后我们需要保证,用户态的页表创建时,USYSCALL分配有物理页,并且在页表内建立了映射
其中xv6关于这创建时方面的设计是这样的
- 进程通过
kernel/proc.c内的allocproc创建.其将先为内存布局中的一些固定区域如trapframe申请到物理内存 allocproc自己不建立映射关系,但是其会调用proc_pagetable创建页表。而proc_pagetable不光是获得一个空页表,其会给allocproc中已经获得物理页的VA在页表中添加记录,完成映射关系。这样其返回后的进程访问trapframe将不会触发页缺失proc_pagetable返回页表,allocproc检查无误后- 最后在free这块的接口实现有些奇怪。其中
proc_freepagetable将会根据sz释放当前进程的页表,同时该用户进程所拥有的物理内存区域(除了TRAMPOLINE,TRAPFRAME的物理页)也会被释放。而freeproc则是调用proc_freepagetable的基础上释放TRAMPOLINE,TRAPFRAME的物理页
而对于我们的USYSCALL,需要做以下修改。其中具体代码只需参考TRAPFRAME的实现即可
allocproc内为USYSCALL申请物理页,并将pid写入该物理页proc_pagetable内为USYSCALL与物理页之间在页表内添加记录proc_freepagetable内释放USYSCALL的页表映射,不释放物理页freeproc释放USYSCALL的物理页
1.5 ulib.c内接口实现
一切就绪后,对于用户而言,其只需要访问USYSCALL这个VA地址即可。所以实现我们在ulib.c内写好的接口即可
int
ugetpid(void){
  struct usyscall* sc;
  sc = (struct usyscall*)USYSCALL;
  return sc->pid;
}
1.6-汇编验证
我们在user/ugetpid.c中写一个基础的验证代码
#include "kernel/types.h"
#include "user/user.h"

int
main(void) {
    printf("My getpid() = %d,ugetpid() = %d\n",getpid(),ugetpid());
    int pid = fork();
    if(pid == 0){//child
        printf("I'm child,getpid()= %d,ugetpid() = %d\n",getpid(),ugetpid());
        exit(0);
    } else if(pid == -1) {
        fprintf(2,"fork error\n");
        exit(1);
    } else {
        wait(0);
        printf("I'm parent,my child's pid = %d\n",pid);
        exit(0);
    }

}
makefile添加编译,随后使用gdb连接
file ugetpid
b main
在xv6启动后,执行ugetpid程序
我们最后可以看到ugetpid在main处停止下来。
而看汇编代码,用户在调用ugetpid后不会执行ecall。这样一来比起ecall执行后的上千条指令,ugetpid仅使用很少的指令就完成了pid的获取,大大加快了系统调用的速度。
0x318 <ugetpid>:      addi    sp, sp, -16     # 在栈上分配 16 字节空间(sp = sp - 16)
0x31a <ugetpid+2>:    sd      s0, 8(sp)       # 将 s0 寄存器(被调用者保存寄存器)保存到栈偏移 8 的位置
0x31c <ugetpid+4>:    addi    s0, sp, 16      # 设置帧指针:s0 = 旧的 sp(即进入函数前的栈顶)
0x31e <ugetpid+6>:    lui     a5, 0x40000     # 将立即数 0x40000 加载到 a5 的高 20 位,a5 = 0x40000000
0x322 <ugetpid+10>:   addi    a5, a5, -3      # a5 = a5 - 3 = 0x3FFFFFFD
0x324 <ugetpid+12>:   slli    a5, a5, 0xc     # a5 = a5 << 12(左移12位,相当于乘以 4096 即页大小)
0x326 <ugetpid+14>:   lw      a0, 0(a5)       # 从 a5 指向的地址加载 4 字节数据到 a0(返回值寄存器)
0x328 <ugetpid+16>:   ld      s0, 8(sp)       # 从栈中恢复 s0 寄存器
0x32a <ugetpid+18>:   addi    sp, sp, 16      # 回收栈空间(sp = sp + 16)
0x32c <ugetpid+20>:   ret                     # 函数返回,跳转回调用者
而且我们编写的测试程序也正确输出
$ ugetpid
My getpid() = 3,ugetpid() = 3
I'm child,getpid()= 4,ugetpid() = 4
I'm parent,my child's pid = 4
2-打印页表
2.1-概念
xv6当中,一个PTE项长度64位,其中
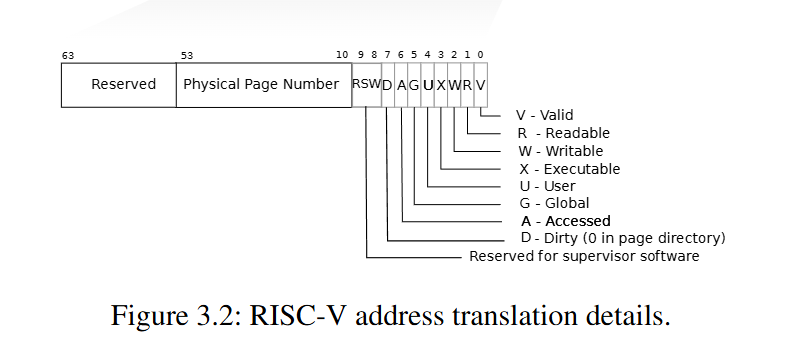
- 0-9位为flag
- 10-53位为PPN
- 54-63位不使用,需要为0
其中一个页表页的大小就是一个页。对于非叶子的页表也,其PPN即下一level的页表的物理地址(因为页表也本身就是按页被分配的,所以其地址自然也是页对齐的)
而整个页表实际上的数据结构就是一个tree。而这里要求1我们以DFS进行遍历输出
2.2-vmprint
所以在vm.c内实现函数如下
void
vmprint(pagetable_t pg){
  pagetable_t pg1;
  pagetable_t pg2;
  int n = 512;
  printf("page table %p\n",pg);
  for(int i=0;i < n;i++){ //level 1
    if(!(PTE_FLAGS(pg[i]) & PTE_V)) //PTE not valid
      continue;
    printf(" ..%d: pte %p pa %p\n",i,pg[i],PTE2PA(pg[i]));
    pg1 = (pagetable_t)PTE2PA(pg[i]);

    for(int j=0;j<n;j++){  //level 2
      if(!(PTE_FLAGS(pg1[j]) & PTE_V)) //PTE not valid
        continue;
      printf(" .. ..%d: pte %p pa %p\n",j,pg1[j],PTE2PA(pg1[j]));
      pg2 = (pagetable_t)PTE2PA(pg1[j]);

      for(int k=0;k<n;k++){ //level 3
        if(!(PTE_FLAGS(pg2[k]) & PTE_V))  //PTE not valid
          continue;
        printf(" .. .. ..%d: pte %p pa %p\n",k,pg2[k],PTE2PA(pg2[k]));
      }
    }
  }
}
2.3-exec捕获
接下来就是在exec内捕获pid=1的程序,并打印其页表
在kernel/exec.c内添加下面这些代码
  if(p->pid == 1)
    vmprint(pagetable);
3-进程内核页表
3.1-内核/用户页表
这里是讲实验要求合理性的前置要求 我们已经知道,在xv6当中,内核态执行的时候,有且仅依赖于一个从系统启动阶段定好布局的页表。后续各个进程进入内核态的时候,都是使用这个页表。
而这里就存在一个小小的问题.即用户在自己的VA space内,将VA作为参数传递给Kernel后,kernel拿到这样的VA参数不能直接使用,必须依靠软件层面访问p->pagetable与vm.c内的函数来获得到PA后再交给真正的硬件.然后硬件查找页表,完成交互.
本处我们的基本设计就是如下
- 进程被创建时,自带内核页表的副本
- 进程进入内核时,需要让satp寄存器使用的不是内核页表而是用进程带的内核页表副本
注意,我们这里说的使用页表,即CPU内部的satp,mmu,TLB等硬件真正使用这套页表。使得汇编层面CPU接收地址后硬件自动寻找页表进行翻译。而不是说基于vm.c内的函数进行地址翻译.
关于页表的规格,大小,级数等实际上需要遵循硬件规范.如xv6所工作的RISCV平台上,在Sv39模式下,就规定需要3级页表.这并不是能够由操作系统编写者所决定的.再如页大小为4096,PTE长度8字节,PTE内部布局均为RISCV规范内定义的.操作系统编写上需要遵守相应规范而不能自己定义
3.2-复制页表
我们需要实现这么一个函数。接收一个页表作为输入,然后在内存中创建一个页表的副本。
这里也就是我们实现在kernel/vm.c内的vmcopy函数
其参考我们的vmprint函数
实现如下
pagetable_t
pgcopy(pagetable_t pg){
  pagetable_t level0,level1,level2;
  int pgsize = 512;
  uint va;
  level0 = (pagetable_t) kalloc();

  //walk to pagetable,get its pa <--> va
  //copy to level0
  for(int i=0;i<pgsize;i++){
    if(!((PTE_FLAGS(pg[i])) & PTE_V))
      continue;
    level1 = PTE2PA(pg[i]);

    for(int j=0;j<pgsize;j++){
      if(!((PTE_FLAGS(level1[j])) & PTE_V))
        continue;
      level2 = PTE2PA(level1[j]);

      for(int k=0;k<pgsize;k++){
        if((PTE_FLAGS(level2[k])) & PTE_V )
          va = ((uint64)i << 24) | ((uint64)j << 16) | ((uint64)k << 8);
          mappages(level0,va,PGSIZE,PTE2PA(level2[k]),PTE_FLAGS(level2[k]));
      }
    }
  }
  return level0;
}其中我们再将其封装为kvmcopy函数
/*create a copy of kernel pagetable*/
pagetable_t
kpgcopy(void)
{
  pagetable_t pg;
  pg = vmcopy(kernel_pagetable);
  return pg;
}
其中不要忘了在defs.h内添加这两个函数
3.3-DEBUG
为了方便进行debug,我们将内核中打印页表的功能暴露给user。
以打印内核页表与用户进程内核页表副本的两个接口函数
kvmprint与ukvmprint
这里如何添加系统调用接口就不给代码了,详见xv6Lab2_syscall
其中这里讲讲我在写完上面这个函数之后遇到的问题 首先是系统启动过程遇到错误,发生panic.
然后就gdb调试吧,先是break panic,然后捕获看调用栈。啊哈,就是vmcopy这个函数被第一次调用,他又调用mappages之后发生的。然后问了问AI,才找到这么两个点
第一个就是关于kalloc的使用。kalloc的确是会给人分配一块物理内存,但是这块物理内存是必然充满垃圾的。
即kernel/kalloc.c这段代码
void *
kalloc(void)
{
  struct run *r;

  acquire(&kmem.lock);
  r = kmem.freelist;
  if(r)
    kmem.freelist = r->next;
  release(&kmem.lock);

  if(r)
  //他妈的,拿内存给我拿好的啊,给我填垃圾什么意思
    memset((char*)r, 5, PGSIZE); // fill with junk
  return (void*)r;
}我没有意识到这一点,拿着充满垃圾值的顶级页表就去做mappages,结果可想而知,通过它都将映射到同一个物理地址,不发生问题才怪了
但是我们不能直接修改这段代码,因为正确的使用方式就是
pagetable_t level0 = (pagetable_t) kalloc();
memset(level0,0,PGSIZE);//将内存值清0
第二个点更难找,就是关于va计算的代码。纯粹是个人犯蠢。因为VA的计算不正确,所以在copy 页表项的VA与PA映射的时候.按照道理来说就是PA动了一个PAGE之后,VA也是相应地到另一个PAGE上,这样才不会触发remap。但是这里就是写错了导致发生remap这个问题
va = ((uint64)i << 24) | ((uint64)j << 16) | ((uint64)k << 8);实际上但凡多看看手册都知道,正确的应该这么写.因为对于VA,VPN的长度为9位,VPO的长度为12位,所以代码改正如下
va = ((uint64)i << 30) | ((uint64)j << 21) | ((uint64)k << 12);3.4-重写的复制页表
所以当我看到上面这些问题之后我决定重写页表的复制函数
这里就是参考的freewalk.其中非叶子的页表的pte均是不可读不可写不可执行,而叶子页表的pte则是若valid,则必然存在可读可写或可执行的属性
pagetable_t
pgcopy(pagetable_t pg){
  pagetable_t kpg = (pagetable_t)kalloc();
  if(kpg == 0){
    return 0;
  }
  memset(kpg,0,PGSIZE); //kalloc的正确使用

  for(int i=0;i < 512;i++){
    if((pg[i] & PTE_V) && (pg[i] & (PTE_R | PTE_W | PTE_X))){ //leaf PTE
      kpg[i] = pg[i];
    } else if(pg[i] & PTE_V) {
      kpg[i] = PA2PTE(pgcopy((pagetable_t)PTE2PA(pg[i])));
      if(! kpg[i])
        return 0;
      kpg[i] = kpg[i] | PTE_FLAGS(pg[i]);
    } else {
      kpg[i] = 0;
    }
  }

  return kpg;
}

//get a copy of kernel page table
pagetable_t
kpgcopy(void){
  return pgcopy(kernel_pagetable);
}
3.5-释放页表
我们需要一个仅释放页表而保留物理内存的函数,这将会用在我们的freeproc.这里的逻辑依旧参考freewalk
//vm.c
void
freepgonly(pagetable_t pg){
  for(int i =0; i < 512;i ++){
    pte_t pte = pg[i];
    if((pte & PTE_V) && (pte & (PTE_R | PTE_W | PTE_X)) == 0){
      freepgonly((pagetable_t)(PTE2PA(pte)));
    } else if((pte & PTE_V)){
      pte = 0;
    }
  }
  kfree((void*)pg);
}
3.6-伴随进程的创建与释放
这里我们的内核页表的生命周期设定为伴随进程的生命周期。所以我们的内核页表将在allocproc时被创建,然后在freeproc的时候被释放
所以在allocproc内我们的措施就是
p->kernelpagetable = kpgcopy();
  if(p->kernelpagetable == 0){
    freeproc(p);
    release(&p->lock);
    return 0;
  }
而在freeproc内就是
if(p->kernelpagetable)
    freepgonly(p->kernelpagetable);
  p->kernelpagetable = 0;
3.7-scheduler
scheduler 控制着进程的切换。
其中硬件层面看到的页表切换的时机分别发生在
- 用户通过trap陷入系统调用
- 用户进程在scheduler控制下分时复用CPU
- 系统调用完成返回用户进程
所以我们需要在scheduler内做的修改挺简单的,当一个进程被拉上来运行的时候,让硬件使用的内核页表不是内核自己的而是用户提供的拷贝,然后当进程结束的时候切换回内核自己的页表
所以在scheduler内的代码如下
for(p = proc; p < &proc[NPROC]; p++) {
      acquire(&p->lock);
      if(p->state == RUNNABLE) {
        // Switch to chosen process.  It is the process's job
        // to release its lock and then reacquire it
        // before jumping back to us.
        w_satp(MAKE_SATP(p->kernelpagetable));//切换到用户提供的内核页表
        sfence_vma();//刷新TLB
        p->state = RUNNING;
        c->proc = p;
        swtch(&c->context, &p->context);

        // Process is done running for now.
        // It should have changed its p->state before coming back.
        c->proc = 0;

        kvminithart();//切换回内核自己的页表,同时刷新缓冲区

        found = 1;
      }
      release(&p->lock);
    }
4-简化 copyin/copyinstr
从这里开始,我们要给用户拷贝的内核页表进行修改,使得其能够使用用户映射
4.1-地址空间布局
这里的一个前提就是
内核使用内核页表的地址空间区域与用户使用的不发生重合(恰好内核在第一个进程创建后,将只使用PLIC以上的地址空间) 所以这个内核页表的布局就为,
- 0-PLIC之间用来做用户地址空间的拷贝。使得内核使用这套页表能够直接使用硬件对用户va进行转换
- PLIC以上归内核自己使用
其中这里需要补充的一点原因就是CLINT这块区域在用户进程的生命周期内都不再使用,所以被忽略用于用户页表映射
4.2-拷贝与清理
所以我们这里实现两个函数,进行对于我们在内核地址空间中划定出来的用户区进行清扫(置零)与拷贝。、
这里接口逻辑被设定为对用户区内的va - va+sz内的区域进行清扫与拷贝
实现如下
//clean va - va+sz of pagetabel
//but not free physical memory it mapping
int
kpgcleanupg(pagetable_t kernelpg,uint64 sz,uint64 va){
  pte_t* pte;
  uint64 bottom,upbound;
  if(sz > PLIC || (va + sz) > PLIC || (va > va+sz))
    return -1;
  bottom = PGROUNDDOWN(va);
  upbound = PGROUNDUP(va+sz);
  //clean 0-CLINT address in kernel page table
  for(int addr = bottom; addr < upbound; addr += PGSIZE){
    pte = walk(kernelpg, addr, 0);
    if(pte == 0 || *pte == 0){ //the page kernel mapping not exists
      continue;
    } else {                   //the page kernel mapping exists
      uvmunmap(kernelpg, addr, 1, 0);
    }
  }
  return 1;
}

//copy user pagetable into kernel pagtable
//address of va - va+sz(sz must smaller than PLIC)
//va - va+sz of kernel pagetable must be clean
int
kpgaddupg(pagetable_t kernelpg,pagetable_t userpg,uint64 sz,uint64 va){
  pte_t* pte;
  uint64 bottom,upbound;

  if(sz > PLIC || (va+sz) > PLIC || (va > va+sz))
    return -1;
  bottom = PGROUNDDOWN(va);
  upbound = PGROUNDUP(va +sz);

  //copy 0-sz user mapping into kernel
  for(int addr=bottom;addr < upbound;addr+=PGSIZE){
    pte = walk(userpg, addr, 0);
    if(pte == 0 || *pte == 0){
      continue;
    }
    int x = mappages(kernelpg, addr, PGSIZE, PTE2PA((*pte)), PTE_FLAGS((*pte)) & (~PTE_U));
    if(x == -1)
      return -1;
  }

  return 1;
}
4.3-内核的更新
由于此时内核内被设定有用户区拷贝。所以当进程的用户区地址空间发生变化时,我们需要同步更新。
在IDE内我们可以通过查看proc->pagetable的所有引用,并找到会更改他的的代码。
而这样的地方分别出现在
allocproc,freeproc,userinit,fork,growproc,exec.其中allocproc是进程刚被创建的状态,此时用户空间大小为0(p->sz==0),内核页表拷贝不需要更新。freeproc则是会直接释放调用户页表与内核页表副本,所以页不用加代码。
所以这里真正要更改的地方就是userinit,fork,growproc,exec
其中对于userinit,fork,exec的逻辑级别都是参照下面这个。在进程的用户页表与用户区大小确定更新后更新内核页表副本
kpgcleanupg(p->kernelpagetable, p->sz,0);
kpgaddupg(p->kernelpagetable, p->pagetable, p->sz,0);而在growproc内,由于其是在增加/缩小用户区的大小。所以我们没有必要从0到sz的全量清扫拷贝。逻辑只需这么实现
if(oldsz > sz){ //收缩
  kpgcleanupg(p->kernelpagetable,oldsz-sz,sz);
} else {        //扩大
  kpgcleanupg(p->kernelpagetable, sz-oldsz, oldsz);
  pgaddupg(p->kernelpagetable, p->pagetable, sz-oldsz, oldsz);
}