Essay2026 / 03 / 29
CSAPP第九章-虚拟内存
我们为什么需要虚拟内存
这里的东西其实并不影响你理解虚拟内存技术细节,如果你急着速成,那么这里的东西大可以跳过。 但我们在这里就是做一个思想实验,如果你在1960年,该怎么说服上层愿意将你的想法用在他们几百万美元打造的机器上。 很显然你需要说明你想出来的东西解决了什么问题,优势在哪里?而且你的想法带来的优势可能足够诱人。 所以虚拟内存技术能够被第一次用在这些机器上,就是要解决过去的一些痛点并且带来很大的优势。 所以我们先来说说痛点吧。如果没有虚拟内存技术最影响到的是什么呢?是你写程序的方式。 首先是我们可以写出庞大的程序,但是计算机运行中必要的存储器容量可能却不够,尤其是那些速度更快的存储器。难道我们的程序就只能存在慢速的存储器内而用不上高速的存储器吗? 其次我们写的程序直接使用物理地址。所以我们可以想象的是你的程序可能写在物理内存上的一块区域,你的同事写的程序占另一块内存区域。有一天你发现你的程序运行总是出错,于是你不断翻看源代码看自己程序的问题,却始终找不到问题所在。但真正的原因却是你同事写的程序没写好,导致它使用访问了你的程序的内存。这就导致说你写的程序再优美如果和一个傻子写的程序在一台机器上运行,那么再优美也没用。 还有我们写程序必须先写好自己要占用物理上的哪一个区域,并且要考虑说会不会与其他人发生冲突。这样写程序可能是累人的。
所以我们再来看用了虚拟内存技术会带来什么。 最重要的是它把原先我们那些底层工作全部“自动化”,并还给我们一个简洁的,抽象的内存模型。我们的程序就跑在一个连续的,近乎无限的,从地址0开始的内存区域。 不用考虑其他程序会不会打扰我们,也不用考虑说程序会不会不够跑在小内存的机器上,保证说随便你写多大规模的程序,以前那些机器用了这项技术都有跑起来的能力。
所以虚拟内存技术凭借这些点,很快取代掉过去的仅物理的内存管理,程序编写方式。为上层开发带来一个完善简洁的体验。那么今天来看,他已经完成成为了一个黑盒,自动静默地在操作系统,CPu中执行着,对程序员透明。但是了解它是怎么把过去方式改造成现在这种模式的原理知识,对于我们编写高效的程序,排查bug是非常有益的。
虚拟内存技术
那么现在我们的物理地址(Physical Address,PA)是直接对应于相应内存的位置 而虚拟地址(Virtual address,VA)呢? 它将磁盘上的内容看作底层存储,内存视作”缓存”。所以虚拟地址的翻译就会看东西有没有在内存中缓存,没有就从磁盘中搬运进来。
最小工作集
所以为了“扩大内存”,虚拟内存在硬件上是涉及到硬盘与内存的。他将硬盘看作“主存”,内存看作“缓存”。在程序加载等时候,就是把disk中被访问过的东西加载到内存中,还没被访问的就不加载。这样在保证性能90%的情况下内存容量需求下降50%以上,让大程序跑在小内存上是可能的。而硬盘与内存之间以页(page)为单位进行交互。页的大小通常为4KB到4MB不等。这是由于disk与memory之间的交互速度比cache与memory之间的交互速度慢太多,通过增大单次预取量来提高命中率从而减少从disk中读取的次数以提高性能。并且这个时候你的虚拟地址可能对应到的是正在内存中被缓存的内容,也可能是没在内存中还在磁盘内未被加载的内容。
页表
确定了虚拟内存技术对于物理上内存与硬盘之间的基本交互逻辑与基本想法,那么我们说说整个虚拟内存技术最核心的地方”地址翻译”。它基本没有改变物理访存时代的disk-memory-cpu的结构,而是说这套硬件上做出相应的优化策略使得虚拟内存技术变得更快更好用。 那么作为最核心的技术”地址翻译”,本质就是数学上的映射,把虚拟地址映射为物理内存地址或者磁盘空间。而这个映射关系就存在页表上。 页表由操作系统管理,存储在内存上,而现代CPU发展出了相应的硬件来优化以加快虚拟地址的翻译过程。 所以页表长什么样呢了
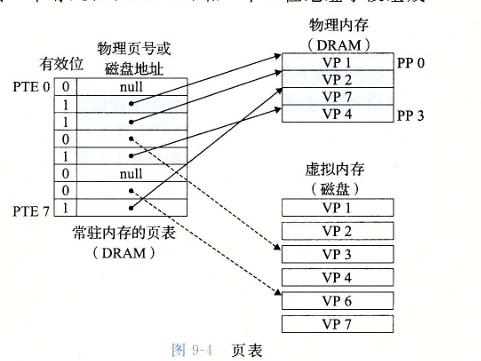
如图,我们的虚拟地址会通过一定手段,定位到相应的表项,而相应的表项指向一块固定大小的内存区域的起始位置或磁盘。其中在这里,这个固定大小区域的概念就是我们说的页(page).
一次翻译的示例
所以我们来想想我们一次访问虚拟内存地址的时候底层怎么帮我们实现这件事? 首先是地址翻译。现代CPU内有MMU(memory manage Unit)这个专门的硬件来做这个工作。 它首先会读取CPU内的一个特定的register得到页表在内存中的物理地址。然后将虚拟地址拆分为VPN与VPO两个部分。VPN会用于索引到相应的表项(page table entry,PTE),然后判断是否有权限访问相应页,以及是否在内存中。如果在内存中那么触发页命中(page hit),如果不在则触发页缺失(page fault)其中页缺失的发生会触发操作系统的相应的异常处理程序,完成缺失页面的加载,页表的更新,以及可能的替代算法与被替代的页的写回操作等,在执行完毕后重新执行虚拟地址的翻译访问。 此时页命中的情况下,CPU内根据页表相应的值PPN,VPO作为PPO二者结合得到物理内存地址(physical address),然后进入物理内存访问系统当中。访问物理内存。 当然目前这个系统的更多细节与优化点我们省去了,你将会在接下来的内容看到补充
内存管理与保护
在刚才的整个流程当中,页表这个数据结构可以加入更多信息来达成控制效果,实现内管理与保护。
管理 操作系统为每个进程都维护一个页表。对于一个进程的生命周期的加载,动态链接,运行,结束的内存管理提供了极大的便利。从加载阶段就可将各section装载到虚拟内存中以自动分配相应pages,动态链接时多进程之间可共享同一块内存区域,运行过程中对于用户的内存申请需求也可以提供一套简洁的方式而不需要关心具体分配到哪些页以及地址
保护 虚拟内存要能被正常地访问到前提时它的确有物理上地内存实体对应。而按照我们的按需加载原则,那么进程与进程之间使用各自的虚拟地址空间,他们彼此不会出现物理访存时期的混论。除此之外,页表结构内添加访问控制,是否内核来进行更细层面的划分。如只读页,可写页,仅内核访问页。
TLB加速地址翻译
一次虚拟地址翻译中可分为下面几步:页表中找PTE,然后检查PTE内位判断权限进行内存保护,在确定可访问后,合成的物理地址就会进入物理内存系统访问,最后物理内存系统返回数据。 其中寻找PTE这一步本质也是一次内存访问过程,不过是直接的物理地址物理访存。 CPU内有一个专门的寄存器 CR3 存储页表在物理内存中的物理地址。CPU的地址翻译阶段开始时就可以通过寄存器的值与虚拟地址的VPN在页表中定位到相应的PTE。 由于这是一次物理地址物理访存,那么它和我们正常的物理访存无异,都会进入到cache-memory这个物理系统当中。所以这就带来一个问题,虚拟内存下的每次访存实际上为多次物理访存的地址翻译与一次物理访存的实际数据读取。作为地址翻译过程中高频访问的PTE,我们希望其能够常驻在cache中以减少地址翻译的损耗,而不是与常规数据指令一起竞争同一cache。 所以现代CPU内设计了一块专门存PTE的cache,称为TLB(Translation Lookaside Buffer) 其缓存,结构,替换等机制基本与常规cache相同。所以地址翻译过程中,会先在TLB内找PTE,hit就返回,没有hit就到内存中找,找到了就同步更新TLB。
多级页表
页表存储了虚拟地址到物理地址的映射关系.其中虚拟地址很多,所以我们必须保证我们的页表能够处理任何一个虚拟地址的情况。在现在的64位系统下,误了完成这件事我们很快会发现对应的表项过多,这会让页表过于庞大,在内存中占用过多内存。
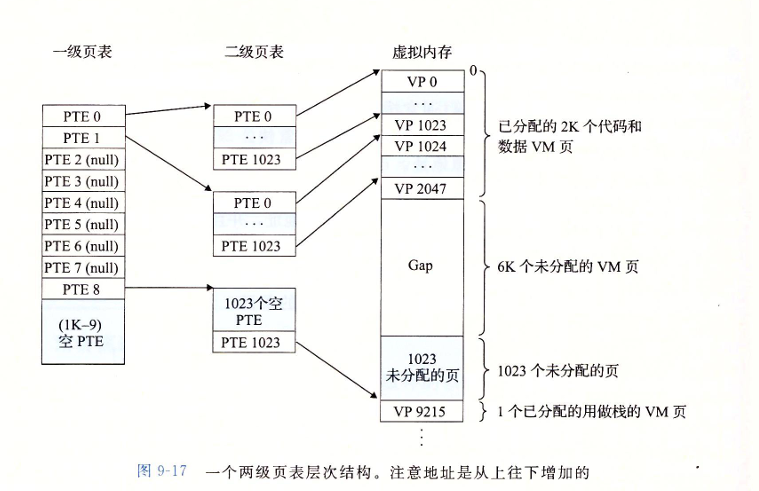
所以多级页表为了解决表项过多的情况,思路很简单。让那些真正在内存,程序会访问的作到粒度细的映射,而那些几乎不可能被程序访问的就做粒度粗的处理,以达到需存储PTE的效果。代价就是地址翻译中到内存中查找PTE的过程耗时更长。