Essay2026 / 05 / 02
CSAPP第十章-系统I/O
1-Unix的一切皆文件设计哲学
Unix系系统的核心设计哲学为一切皆文件。他将系统中所有类型的资源(硬件,数据,进程,网络等)都抽象为一个统一的接口-文件。
也就说说我们可以通过open,read,write,close这同一套标准操作来访问几乎任何东西。
所以Unix系统内将文件分为下面这些类型,这具体体现在
- 文件与目录 普通文件与目录文件类型
- 硬件设备 被表示为/dev/目录下的设备文件。
- 进程信息 /proc/ 文件系统允许通过文件直接查看和修改进程的内存、状态等。
- 系统信息 /sys/ 文件系统提供了访问内核参数和硬件配置的统一文件接口。
- 通信通道 管道(pipe)和套接字(socket)也是文件。这让“把一个程序的输出直接作为另一个程序的输入”成为可能。
2-简易的I/O原理
在我们的read/write操作下。一般经过的结构为
用户区缓存 ---- 页缓存(系统) ---- 磁盘(disk)
在如在写入文件的情况下,其先对用户区缓存进行修改,随后修改被异步拷贝至页缓存,随后页缓存被异步拷贝至磁盘。
在mmap这种函数下,他允许我们直接将用户缓存映射到页缓存上,这样的读取修改操作,由于没有用户区到页缓存的同步带来的一次拷贝,所以减少了一次拷贝次数。这对于单次写入/读取大量数据而言,是一种保证系统调用代价与执行速度的好的权衡之策。
Linux也提供了对于用户区缓存到磁盘的直接映射。
O_DIRECT标志:直接 I/O,用户缓冲区与磁盘之间直接传输(通常通过 DMA),跳过页缓存。数据库软件常用此法。O_SYNC标志:仍经过页缓存,但每次写操作同步等待落盘。
3-Linux系统提供的函数
Linux系统内提供了大量关于文件I/O等操作相关的函数,并且因为Linux内核为C语言开发,所以我们可以直接获取到系统层级的函数接口。其中直接使用系统函数是一种底层的操作,对于I/O而言每一次使用系统函数都是一次系统调用,涉及到内核态用户态切换的过程,耗费可能3000到15000个时钟周期不等,所以除非你是在开发底层内容或者清楚你在做什么以及清楚代价,否则不要直接使用他们。这里仅讲open,read,write,close的用法。你可以访问这个网站 Linux man page online来获取到Linux的官方手册,获得这几个函数的具体说明使用的第一手资料。
3.1-open
open函数将打开某个文件,并且在无相关文件时可能创建文件。其将在打开成功时返回一个int值作为file description,可以粗浅理解为文件ID。在接下来的open,wirte,close等操作都需要这个file description.如果失败,则会返回-1.
#include <fcntl.h>
int open(char *path,int flags,/* mode_t mode */);- path 为文件所在路径,其既可以是绝对路径也可以是相对路径
- flags 为被打开文件设定访问方式与额外指示,以此来指明访问方式,写入方式,创建的子进程是否能够继续通过其返回值访问文件等行为。
- mode mode非open函数的必选项。其作用为在
open需要创建一个文件时用于指定新文件的初始访问权限。其中进程自身存在umask,其通过umask & ~mode的方式对mode指定的权限进行 筛选。
3.2-close
close将关闭某个文件描述符(file description)。其中成功返回0,不成功返回-1
#include <unistd.h>
close(int fd);
其将通过file description关闭相应的file。注意在UNIX的一切皆文件哲学下,close实际上是一个比open更加通用的函数。其还可以关闭socket,pipe等。
3.3 - read/write
read函数从file description内读取n个字节到用户指定缓冲区.其中read也具有“泛用性”,可用于socket,pipe等
//返回读取到的字节数
#include <unistd.h>
ssize_t read(int fd, void buf[count], size_t count);
而write函数与read类似
//返回写入的字节数
#include <unistd.h>
ssize_t write(int fd,void buf[count],size_t count);
其中在unistd.h头文件内定义了下面这几个宏,表示标准输入输出错误的file description
/* Standard file descriptors.  */
#define STDIN_FILENO    0   /* Standard input.  */
#define STDOUT_FILENO   1   /* Standard output.  */
#define STDERR_FILENO   2   /* Standard error output.  */
所以以下面这个程序举例
#include <unistd.h>
int main(){
    char buffer[10];
    read(STDIN_FILENO,buffer,10);
    write(STDOUT_FILENO,buffer,10);
    return 0;
}
3.4 - 错误处理
在刚才的四个系统调用函数内,每个函数被会在正常工作时返回相应的值,但是在异常时返回0或负值。所以如果要健壮地使用系统函数必须在每次调用后检查返回值,像是下面这样
int main(){
    char buffer[10];
    int fd =  open("./hello.c",O_RDER);
    if(fd < 0) return;
    if(read(fd,buffer,10) == 0 )return;
    if(write(fd.buffer,10) == 0) return;
    if(close(fd) == -1) return;
}
4-健壮的I/O
如果直接使用系统调用来完成文件操作而且要健壮非常麻烦,所以我们需要把系统级别的I/O接口进行封装,变为健壮的,可直接使用的I/O相关API。
4.1-无缓冲读写
在系统级别的read/write函数中,我们进行读取/写入操作时,正常情况下其将返回读取到的字节数。但是有一些边界情况需要考虑
- 执行过程中遇到error/信号中断,返回负值
- 对于网络socket等情况,在未遇到EOF时可能只读写一部分而不等待接下来字节的到来。即short count
- 遇到EOF,提前结束
所以我们健壮的read/write需要做到
- 遇到错误/中断时,如果是信号中断应该自动再次调用自身,遇到其他错误提前返回
- 应该在未遇到EOF前不断地读取/写入确保能够读取/写入用户指定的n字节。而不是单次的read/write
所以我们的read/write的API与实现如下
/**
 * @brief Unbuffered read n bytes from file to user buffers
 *        (return short count only if it excounters EOF)
 * @param[in] fd file description
 * @param[out] usrbuf buffer user created
 * @param[in] n_bytes bytes need read
 * @return  return the bytes actually readed on success
 *          return -1 when encounter errors
 * @retval -1     If an error occured (errno is set appropriately)
 * @retval 0      If EOF encountered before reading any data
 */
ssize_t rio_readn(int fd, void *usrbuf, size_t n_bytes)
{
    size_t nleft = n_bytes;
    ssize_t nraed;
    char *bufp = usrbuf;
    while (nleft > 0)
    {
        if ((nraed = read(fd, bufp, nleft)) < 0)
        {
            if (errno == EINTR) // interrupted by signal
                nraed = 0;      // call read() again
            else
                return -1; // errno set by read()
        }
        else if (nraed == 0)
        {
            break;       //EOF
        }
        nleft -= nraed;
        bufp += nraed;
    }
    return n_bytes - nraed;
}

/**
 * @brief Unbuffer write n bytes into file from user buffer
 * @param[in] fd file description
 * @param[out] usrbuf pointer to  buffer user created
 * @param[in] n_bytes bytes need write
 * @return
 */
ssize_t rio_writen(int fd, void *usrbuf, size_t n_bytes)
{
    size_t nleft = n_bytes;
    ssize_t nwritten;
    char *bufp = usrbuf;
    while(nleft >0){
        if((nwritten =  write(fd,bufp,nleft)) < 0){
            if(errno == EINTR){
                nwritten = 0;
            }
            else{
                return -1;
            }
        }
        nleft -= nwritten;
        bufp += nwritten;
    }
    return n_bytes;
}
4.2-带缓存读取
在刚才的例子里面,如果我们想要类似逐行读取文件内容,那么就要不断地read文件,而每一次read都是一次系统调用,所以开销较大。一种好的想法为一次系统调用就预取大量内容到用户区进行缓存,接下来的读取都从缓冲区读取。 这样我们I/O的执行速度会更快
注意:本处我们的read实现并非线程/进程安全的。实际上我们并没有做对于文件已被修改的情况下更新用户区缓冲区的操作,也就是说在多进程/线程的环境下我们的缓冲区实际上可能存储着旧数据。所以本处的RIO仅适用于单进程单线程的情况,作用为体现引入用户区缓冲区以减少系统调用次数的思想。
4.2.1-缓存数据结构与方法
首先是用户缓冲区的数据结构,如下
#define RIO_BUFSIZE 8192
typedef struct{
    int rio_fd;                 //file description
    int  rio_cnt;               //Unread bytes count
    char* rio_buf_ptr;          //pointer to start of unread buffer
    char rio_buf[RIO_BUFSIZE];  //pointer to start of total buffer
}rio_t;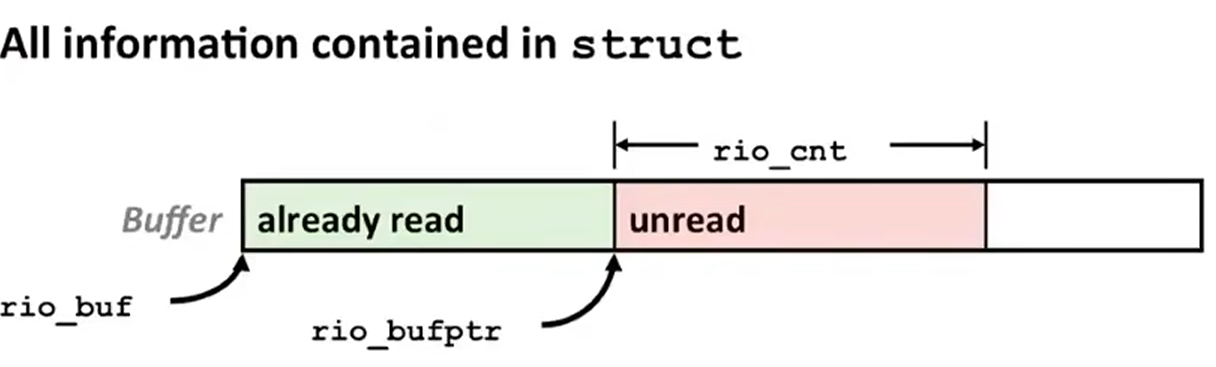
其中这个数据结构的方法需要
isempty() 方法,判断缓冲区的未读内容是否为1空
- cnt==0时,表示缓冲区内内容均被读过
- cnt>0时,表示缓冲区内容还有未读
refill() 方法,在缓冲区未读内容为空时调用一次系统read更新
- 将rio_bufptr置为rio_ptr的值
- 调用一次系统read填充缓冲区
- 更新rio_cnt
rio_init 方法,初始化缓冲区
- 将rio_bufptr置于rio_buf的值
- 将rio_cnt置零
- 接收输入的fd,设置rio_fd = fd 所以在代码上,我们需要先实现上面这三个方法
bool isEmpty(rio_t* rp){
    return rp->rio_cnt == 0;
}
ssize_t refill(rio_t* rp){
    //该循环体目的为信号中断发生时重新执行read
    //目的是保证能够完成一次有效的read()
    while(rp->rio_cnt <= 0){
        rio->cnt = read(rp->rio_fd,rp->rio_buf,sizeof(rp->rio_buf));
        if(rio->cnt < 0){       //中断/错误发生
            if(errno != EINTR)
                return -1;
        }
        else if(rio->cnt == 0){  //遇到EOF
            return 0;
        }
        else{
            rio_bufp = rio_buf;
        }
    }
    return rio->cnt;
}
void rio_init(rio_t *rp, int fd){
    rp->rio_fd = fd;
    rp->rio_bufp = rp->rio_buf;
    rp->cnt = 0;
}
4.2.2-包装系统read()
有了缓存,接下来我们封装下系统级别的read,得到我们的read(). 这个read的行为与系统read几乎一致。
- 缓冲区未读为空时重新填充缓冲区
- 在缓冲区未读部分中读取相应字节数
ssize_t rio_read(rio_t* rp,char* usrbuf ,int n_bytes){
    int unread = 0,cnt = n_bytes;
    if(isEmpty(rp)){
        unread = refill(rp);
        if(unread == -1) return -1;
        else if(unread == 0) return 0;
    }
    unread = rp->rio_cnt;
    if(unread < n_bytes) cnt = unread;
    memcpy(usrbuf,rp->rio_bufp,cnt);
    rp->rio_cnt -= cnt;
    rp->rio_bufp += cnt;
    return cnt;
}
4.2.3-读取行/按字节读取
现在我们要解决short_count问题。
其中读取一行的函数如下 核心想法就是一个个字符进行读取,到达最大值/换行符停下输出
ssize_t rio_readlineb(rio_t* rp, void* usrbuf, size_t maxlen)
{
    int n, rc;
    char c;
    char* bufp = usrbuf;
    for (n = 1; n < maxlen; n++) {
        if ((rc = rio_read(rp, &c, 1)) == 1) {
            *bufp++ = c;
            if (c == '\n') {
                n++;
                break;
            }
        }
        else if (rc == 0) {
            if (n == 1) {
                return 0;
            }
            else {
                break;
            }
        }
        else {
            return -1;
        }
    }
    *bufp = 0;   //添加字符串终止符 0
    return n-1;  //排除终止符
}
而按字节数读取的函数也是如此
size_t rio_readnb(rio_t *rp,void * usrbuf,size_t n_bytes){
    size_t nleft = n_bytes;
    ssize_t nread = 0;
    char* bufp = usrbuf;
    while(nleft > 0){
        if((nread = rio_read(rp,usrbuf,n_bytes)) < 0){
            return -1;
        }
        else if(nread == 0){
            break;
        }
        else{
            nleft -= nread;
            bufp += nread;
        }
    }
    return (n_bytes - nleft);
}
5-文件元数据
文件元数据是操作系统给每个文件配备实现的。包含的信息有文件的大小,访问权限,文件类型. Linux提供了下面一套API来获得文件的元数据
#include <sys/stat.h>
#include <unistd.h>
int stat(const char *filename,struct stat *buf);
int fstat(int fd,struct stat *buf);
他们将获取文件元数据拷贝至用户区缓存 接下来可通过其定义的宏获得相应的元数据
stat(filename,file_meta);
S_ISREG(file_meta) //是普通文件吗
S_ISDIR(file_meta) //是目录文件吗
S_ISSOCK(file_meta)//是网络套接字吗
6-共享文件
Linux提供了一套“共享文件”的机制,来允许多个进程可以打开同一个文件并进行管理。
像是下图,我们可以在不同的软件上打开同一个文件一样
那么Linux采用了三级数据结构来进行管理
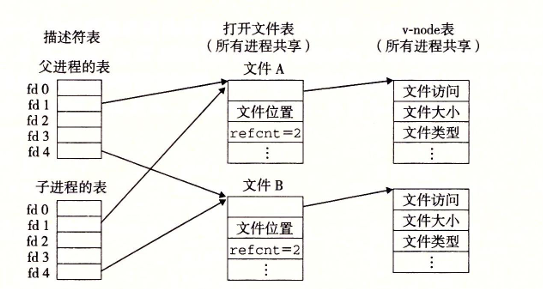
首先是v-node表,这个由操作系统维护全局共享,他的责任为记录整个系统内正在被进程名义上使用的文件。记录着文件的大小,类型,对应磁盘数据块的指针,每个文件仅此这一个表项。
然后是打开文件表(open file table),这个由操作系统维护全局共享.他的责任为记录打开文件的过程信息。如打开的是v-node的哪个文件,目前的读写未知,打开模式等等。所以会有多个表项指向同一个v-node表项。
最后是描述符表(file description table),这个由每个进程独有.他的责任为记录进程内的fd指向的是哪一个打开文件表的表项。每个进程都有自己专属的表。所以允许单个表内的多个fd指向同一个打开文件表的表项。更1还有进程之间的fd指向同一个打开文件表表项。
那么对于操作系统而言,其需要保证其1维护的两张表内,如果某一表项不再被任何进程使用则要能够标记释放。
这里操作系统采用的方法为在每个表项内额外维护一个值称为ref_cnt.当表项被上一级的表内某个表项引用时,ref_cnt加一。同样当其不被引用时ref_cnt减一,若为0则释放。所以在刚刚的v-node与open file table内的表项都维护这这么一个引用计数器。
所以我们来看看下面这个简单的代码段,在hello.txt内的内容为hello
char c;
int fd = opne("hello.txt",O_RDONLY);
fork();
int nread =  read(fd,&c,1);
printf("c = %c\n",c);
先告诉你允许结果,会print出下面两个结果
c = h
c = e
我们接下来要解释为什么。 造成这一切的原因在于子进程被创建时,其fd table与父进程完全相同。 我们都知道,fork会创建子进程,而子进程的状态,数据基本都是从父进程那里复制的,这其中也包括file description table 所以对于子进程来说,他自己的fd指向的open file table的条目是和父进程的open file table的条目是一致的。假如当子进程优先读取字符时,那么它此时就读到了h,而此时open file table条目更新,偏移量加1. 等到父进程执行read时,它此时就读到的是e而不是h。
接下来借此再说说printf printf和我们在RIO中写过的一样,是带有用户区缓冲区的IO函数。 所以我们输入给printf的字符串不会立即write进STDOU_FILENO文件。而是在缓冲区缓存,printf会在某些条件下触发,一次性将缓冲区内容写入STDOUT中 而这个触发条件在shell条件下为换行符,在非shell的环境下还可以为缓冲区满了 以shell为例,讲解下面这个简短的C代码
printf("Hello ");
fork();
printf("World\n");
从直观理解来看,父进程会完整输出hello world,而子进程只会输出World。 但实际运行结果为
Hello World
Hello World
结合刚才我们说的,子进程相当于父进程的拷贝。
由于父进程在fork前,其printf的内置缓冲区内容没有被清空输出。
所以子进程复制时,父进程的printf的缓冲区内容就被同步复制过来。
这就导致子进程的printf缓冲区也有一份hello,在其执行到printf("World\n");的时候由于换行符清空缓冲区输出,导致子进程也可直接输出完整的Hello World
所以对于父进程而言,在fork前一般需要清空IO的用户区缓存以免给子进程带来”脏数据”
7-重定向
重定向操作就是修改fd table的表项所指向的open file table的表项。 一个经典的用法为将一个进程的标准输出的fd改向到某个文件,使得输出内容到磁盘文件内而不是shell窗口
ls > list.txt采用的API为dup2
int dup2(int oldfd, int newfd);8-总结与拓展
本章内容只是系统级IO编程的冰山一角。在我们需要做底层工作时我们才直接使用系统的I/O函数,其他情况下,我们会对系统级别的I/O函数进行封装形成一些库。其中由于每次使用系统IO函数都要涉及一次系统调用,所以我们给其添加用户区缓存以此来减少对于系统IO的调用次数,在RIO内,它适用于网络IO,解决short count问题,处理可能的信号中断/异常,添加用户区缓存减少系统调用次数。 除此之外,我们知道Linux通过三级数据结构完成了多进程直接可共享文件,以及重定向的原理。 但是不得不说,我们所讲的只是Linux系统编程下IO相关的冰山一角。实际上我们推荐你拓展阅读 《Advanced Programming in the Unix Enviroment》与《The Linux Programming Interface》他们会详细讲到Unix/Linux系统的大量原理特性以及编程方法 前者由资深Unix程序员W.Richard.Stevens所著,可以看作是Unix编程领域的百科全书。 后者为Linux man-pages核心维护者Michael Kerrisk所著,相当于Linux的官方手册。