Essay2026 / 03 / 29
CSAPP第五章-理解现代处理器
现代处理器的设计是极其复杂的。尤其是x86这种必须保证向后兼容的,在支持现代特性的时候,必须为当初考虑不周全的设计”擦屁股”,补丁上打补丁。本文以历史的方向,从8086的简陋设计开始,从CPU的发展路径上看到在追求极致效能的路上遇到了哪些问题以及解决方案,一气呵成组成现代CPU的大体结构。
1-五级流水线
1.1-8086时代-无流水线
x86始于Intel于1978年发布的16位处理器8086。即使是今天的x86处理器,当年8086上的指令依旧得到保留。
这个时候的CPU设计极其单纯,从内存中获取指令,执行指令,然后再去内存中取下一条指令。只有取指与执行两步。
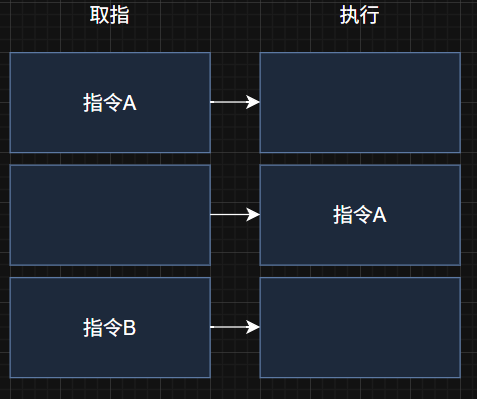
从时间上算,CPU需要花费多个时钟周期完成一条指令。假设取指平均花费周期数为,执行花费周期数为。那么CPU执行一条指令花费时间为
1.2-80486时代-五级流水线
8086时代下的CPU硬件利用率极低。当执行单元工作期间,取指单元就在”睡觉”。在80年代到90年代期间,CPU核心频率一路飙升,而内存速度已经跟不上了。 在这样的背景下,1989年Intel发布了32位的80486处理器。其首次在x86型号CPU内引入 硬件缓存(L1 Cache) 与 数据转发(Data Forwarding).更重要的是,其上真正实现了五级流水线技术。
下面是一个理想情况的五级流水线示意图。
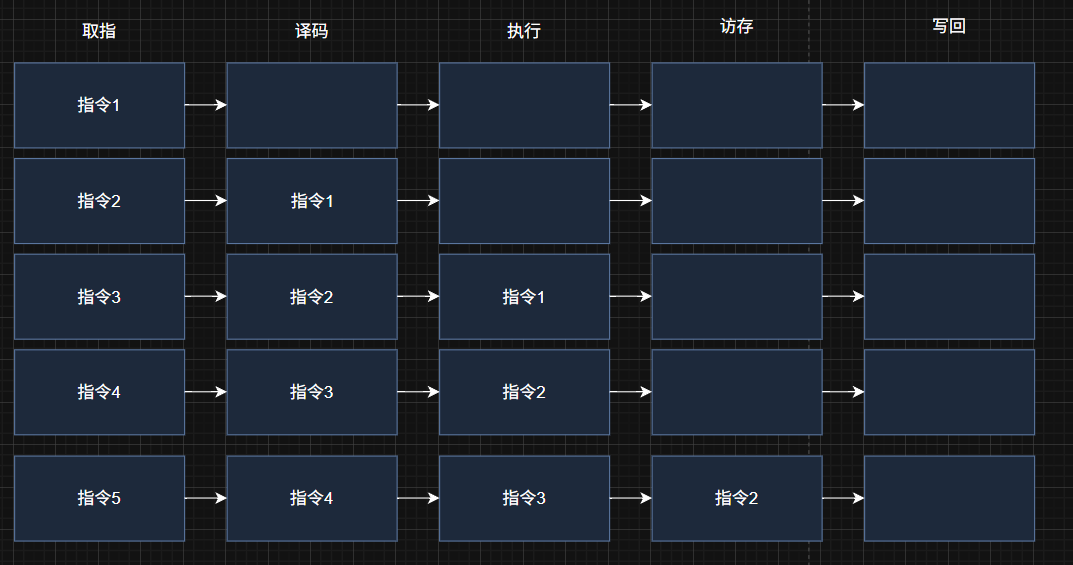
在这种理想情况下,我们假设每条指令各阶段耗时相同的情况下。CPU执行完一个指令花费的周期数取决于耗时最长的那个阶段,我们记为. 那么这种流水线充满状态下,CPU每的时间就有一条指令被执行完成
很明显,CPU的效率提升了,所以后续CPU继续优化性能的策略为,增加流水线的阶段,增加流水线数量,更好应对流水线异常情况,缩短流水线耗时长的阶段的用时。
2-分支预测
理想情况下的流水线效率受耗时最长阶段的制约。但是还有一个情况同样制约着流水线的性能,这就是分支。
2.1-被分支制约的80486
80486引入的五级流水线相当于一次芯片性能的工业革命。但是对于分支这样的指令却是”束手无策”的。
在x86上,一个分支要能够被正确执行,一是需要知道分支要跳到哪,如果是直接跳转,这将在译码阶段后知晓;如果是间接跳转,那么还需要等到访存阶段。二是需要知道该不该跳到分支,这将在执行阶段后确定。所以取指器遇到分支指令后,必须先等待,直到分支指令确定了是否跳转与跳转目标后,才会开始继续往流水线里面送指令。在流水线上,就会导致最新进入的指令与分支指令之间至少差了2个阶段以上,即 流水线气泡。
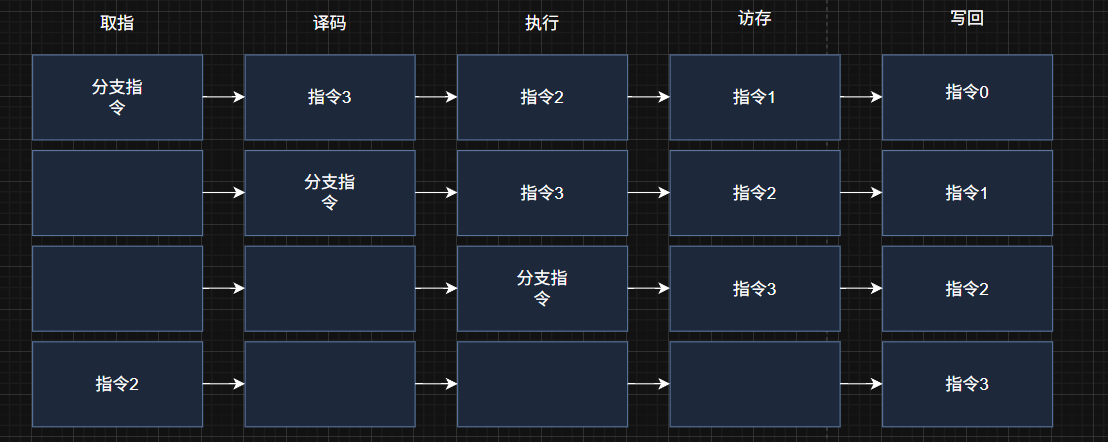 由于流水线没有被填满,CPU的效率便会发生下降。假如在五级流水线内指令流稳定以10个指令2个空的方式出现,那么CPU执行单指令平均用时就变为
2.2-分支预测演进
前面我们已经看到了,造成效率下降的原因为——取指单元取到分支语句后发生”罢工”。所以解决方法很简单,让取指单元不要停下,继续取指令。但是我们不能让其盲目地取指令,需要一个单元能够较为准确预测是否进入分支以及分支地址,以控制取指单元到哪取指。这就是分支预测技术。
它将基于历史记录,在取指阶段就能给出预测结果,不让取指器停下来。那么等到分支指令进入执行阶段后,在EU内的分支单元会判断ICU的分支预测是否正确。不对就要清空那些取值器输入进流水线的错误指令,从正确位置重新开始取址执行。
在历史上,Intel在1993年发布的奔腾系列处理器首次引入动态分支预测机制。CPU内部集成一个称为BTB的小型缓存,用于存最近执行过的分支指令的历史与跳转目标,从而在取到相同分支指令时直接在缓存里面选择一条最有可能的历史记录。猜对流水线满负荷运转,猜错则损失几个周期。在后续处理器设计中,对于分支预测的设计逐渐复杂,以提高分支预测的准确率。现在分支预测技术的准确率能够达到90%以上,在某些场景下甚至能够达到99%。
3-超标量与乱序执行
现代处理器有两个重要的特性,分别为 超标量(superscalar)与乱序(out-of-order)。这两个特性的目的很简单,就是进一步地提高与压榨CPU的性能。
其中,有两种下界限制着CPU所运行的程序的最大性能。一是指令间有严格顺序的情况下,CPU处理每条指令的时间,即 延迟界限。二是指令并行化执行过程中,CPU的功能单元的原始计算能力(能够同时算多少加法除法之类的),即 吞吐量界限
3.1-超标量
在奔腾之前的CPU都是单流水线的,每个阶段只能容纳一条指令。而超标量就是通过让某些阶段具有重复的硬件资源以达到指令级并行(如多路译码器,发射分配器,冗余执行单元)。
1993年,基于P5架构的奔腾系列CPU首次实现x86处理器上的超标量。其内设计了U,V两条管道。其中U管道是全能的,而V管道只能执行简单的整数指令。但是这个阶段的超标量很”笨”。一是由于顺序执行,如果U管道遇到一条复杂指令耗时较长,那么V管道也必须跟着停顿。二是它需要编译器来优化代码以用上V管道。所以这个时候的超标量技术依旧有许多可优化空间。
3.2-乱序执行
所以在1995年,Intel推出了新一代P6架构的奔腾系列CPU。这一代CPU基本可以称为现代x86系列CPU的基石。
这一代CPU引入了三个核心组件。最重要的是乱序执行的引入使得超标量得以更加高效地运行。
- 指令拆解 在译码阶段,将不定长,复杂的CISC指令拆成类似RISC的微指令,方便后续EU的执行.这是乱序执行的基础。
- 寄存器重命名与寄存器文件 解决指令并行化问题。将指令中程序员可见的寄存器映射到不可见寄存器(寄存器文件)上以解决假相关问题。让原本排队的指令并行执行。其中可见寄存器通常有十几个,但是不可见的却有上百个。
- 保留站与退役单元 一,ICU输出的微操作指令会到达保留站。这里的指令时刻监听公共数据总线,等待自己需要的操作数被计算出来。从这里开始,指令便开始乱序执行了。二,退役单元负责将这个乱序执行的结果依旧按照程序顺序执行方式的顺序交付。大体机制为,在微操作到达保留站的同时,会在ROB(写入重排序缓冲区)中严格按照程序的原始顺序占位。(队列般的数据结构)。一条指令的执行完毕会同步在ROB内更新为已完成状态与暂存计算结果。退役单元将始终关注队头的状态,只要队头的状态变为已完成那么就出队,把ROB的临时结果搬到架构寄存器文件中转为可见状态。
注:个人理解,这个乱序执行的逻辑类似于计算机网络中的SR(Selective Repeat,选择重传)协议。后续指令无需等待前面指令完成与否,而是根据自己的操作数是否准备完成而选择是否执行,这就导致指令在时空上的执行顺序是乱序的。但是对于”上层”的程序员来说,指令依旧需要”按顺序执行”,所以乱序执行的指令就要缓存结果而不丢弃,以在后面按顺序交付。