Essay2026 / 03 / 21
汇编进阶-数据对齐与变长栈帧
本文关注程序运行时寄存器与内存之间的交互。由于底层硬件对数据类型的内存地址有对齐要求,编译后的汇编代码有时会“反直觉”。本文将重点解析数据对齐的原理,解释变长栈帧机制,来消除这种”反直觉”
1-寄存器与栈
寄存器中的数据到栈需要三个步骤
- 通过
sub $N %rsp开辟栈空间 - 通过
%rsp加上偏移量定位到具体内存地址 - 用
mov指令传送从寄存器传送数据到内存
而从内存中拿出数据,释放空间也是类似的三个步骤
- 获取到目标数据的内存地址
- 使用
mov指令从内存往寄存器传送数据 - 通过
add $N %rsp释放栈空间
具体的做法有两种,一种是硬件自动完成栈指针调整与数据移动,还有一种是程序员(编译器)手动控制每个环节。用通俗的话来说就是有自动挡和手动挡
1.1-PUSH指令与POP指令
自动挡为push指令和pop指令 .push指令将自动在栈内开辟一块8字节的空间,将寄存器的原值存放进去。 pop指令则相反,从栈顶往下读8个字节的数据到寄存器中,然后释放栈顶8字节的空间。 但滥用这种自动指令存储会带来问题,如下例子
int diff(int x,int y){
    int a =x;
    int b =y;
    return a+b;
}假如要用push指令给变量a,b在栈上开辟空间存储,就会如下(实际上编译器未强制情况下会直接用寄存器存储而非内存)
pushq %rdi
pushq %rsi这两条push指令开辟了16字节的空间,但是实际上两个int类型的数据只占8字节。如果局部变量更多,那么我们就要用更多的push指令,浪费更多的空间,这样的损失是不可容忍的。所以push指令基本只用于保存被调用者保存寄存器, pop指令就用于恢复内存中被push的寄存器值
1.2-”手动”管理
所以现代编译器依旧采用”手动”方式来给你的变量存到内存中,以获得更高的空间利用率与执行效率。
这个手动的方式就是我们前面说的三个步骤,
同样以下面这个函数为例,其有四个short型变量要存到栈里
volatile阻止变量被优化存到寄存器中。而在stack_demo中调用getchar,是因为叶子函数会被优化使用红色区(red zone,通常为栈指针往低位的128字节的未使用空间),通过调用getchar()让stack_demo为非叶子函数,使得编译器显式操作栈指针分配空间。
void stack_demo(){
    volatile short a,b,c,d;
    a = getchar();
    b = getchar();
    c = getchar();
    d = getchar();
}
输入命令,禁用帧指针编译,其中存储变量相关的代码如下
gcc -S -fomit-frame-pointer test.c -o test.s编译器会根据优化等级、帧指针使用情况等因素,选择不同的栈分配方式,但最终局部变量都会位于栈内存中(除非被优化到寄存器)
stack_demo:
    subq    $24,%rsp
    movw    %ax,8(%rsp)
    movw    %ax,10(%rsp)
    movw    %ax,12(%rsp)
    movw    %ax,14(%rsp)
    addq    $24,%rsp
可以看到,四个局部变量被分配到连续存储的区域。其中,关于为什么rsp减去24而不是8,你将在下一节数据对齐中看到。
2-数据对齐
数据对齐(Data Alignment) 要求某种数据类型其内存的起始地址必须为其大小的整数倍 如8字节的long要求其内存地址为8字节的整数倍。数据对齐是”手动操作”内存必须知道的知识
2.1-为什么要数据对齐
许多CPU访问未对齐的内存时会产生异常或多次内存访问(现代x86仍会显著降低性能)。所以在ABI的要求下,编译器在将数据从寄存器转移到栈的过程中就会遵守这一规定。
2.2-数据对齐规则
自然对齐 每4种数据类型的自然对齐要求地址通常为自己大小的整数倍
如对于int类型数据,内存地址为0x80004004为对齐状态,地址为0x80004003为未对齐状态
| 数据类型 | 地址要求 |
|---|---|
| char | 1 |
| short | 2 |
| int | 4 |
| long | 8 |
| float | 4 |
| double | 8 |
| 指针 | 8 |
结构体对齐 结构体内部各元素按自然对齐存放,编译器会在成员之间与结构体末尾插入填充来满足对齐 以下面这段C的结构体为例
struct S{
    int i;
    char c;
    int j;
}
在不考虑数据对齐的情况下,按最小的9字节分配如下图
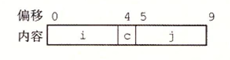
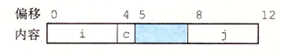
其中,i的偏移量为0,满足对齐。c的偏移量为4,满足对齐。j的偏移量为5,不满足对齐。所以j的开始地址后移至偏移量为8的位置.即后移3字节,中间的3字节就不作使用,算作被”填充”
栈帧对齐 即保证指向栈顶/栈帧顶的%rsp为16字节对齐
- 函数调用前,%rsp必须是16字节对齐
- 函数入口处(call压入返回地址后),此时%rsp mod 16 = 8
- 分配栈帧时,确保%rsp在调用任何其他函数前再次变为16的倍数
现在解释第一节的汇编代码中,为什么分配空间为24字节而非8字节
stack_demo:
    subq    $24,%rsp
    movw    %ax,8(%rsp)
    movw    %ax,10(%rsp)
    movw    %ax,12(%rsp)
    movw    %ax,14(%rsp)
addq $24,%rsp按照栈帧对齐规则,stack_demo函数的入口/开始处,由于有返回地址,此时%rsp非16字节对齐状态(%rsp mod 16 = 8)。现在给4个short类型变量开辟空间,由于四个short占用8字节。按照最小的18字节奉陪,每个short都对齐的情况下。则%rsp向下开辟8字节空间后就可以保持16字节对齐。
但是编译器选择在此基础上再增加16字节的空间以做”冗余”。这是因为本处编译器对于栈帧的布局偏向一种保守策略,让数据与栈指针之间留有8字节的空间以避免与可能的临时数据或对齐填充冲突。
所以基于保守的栈帧布局策略,数据实际占用的8字节空间,栈指针要求的16字节对齐,编译器选择分配最小的24字节栈空间用以存放四个short局部变量,并且从8(%rsp)往高位存放数据。
3-变长栈帧
对于大部分情况,由于函数内的局部变量等的大小在编译时是已知的,所以编译器可以在编译阶段预先确定好为栈帧分配多少空间。在C语言中,C99中支持的变长数组,使得有些栈帧所占的空间是变长的。这就要求我们能够根据运行时的变量来动态分配栈帧空间,这就是变长栈帧
下面是CSAPP内的例子,vframe函数
long vframe(long n,long idx,long *q){
    long i;
    long *p[n];
    p[0] = &i;
    for(i=1;i<n;i++){
        p[i] = q;
    }
    return *p[idx];
}
产生的汇编代码如下
vframe:                        注释
    pushq   %rbp                保存旧的%rbp,此时栈指针16字节对齐
    movq    %rsp, %rbp          设置帧指针
    subq    $16, %rsp           开辟16字节的空间存储i与金丝雀值
    movq    %fs:40, %rax
    movq    %rax, -8(%rbp)      将金丝雀值入栈
    xorl    %eax, %eax          将%eax归零
    leaq    22(,%rdi,8), %rax   计算p所需空间(额外加22用作对齐调整)
    andq    $-16, %rax          确保栈指针16字节对齐
    subq    %rax, %rsp          给p分配空间
    leaq    7(%rsp), %rax       确定P的起始内存地址
    shrq    $3, %rax
    leaq    0(,%rax,8), %r8     设置%r8为&p[0]
    movq    %r8, %rcx           设置%rcx为&p[0]
    .......
.L3:
    movq    %rdx, (%rcx,%rax,8) 设置p[i]值为q
    addq    $1, -16(%rbp)       i++
.L2:
    movq    -16(%rbp), %rax     从栈中读取i
    cmpq    %rax, %rdi          比较n与i
    jg      .L3
    ...........
这段对于寄存器与内存之间值得交互有点难理解,我们一步步来看。
首先,函数入口处,在未执行任何指令得情况下,栈指针%rsp会因为返回地址而处于未对齐状态(%rsp mod 16 == 8).
pushq %rbp
movq %rsp,%rdp
如上,这两条指令是为了设置帧指针,第一条push指令保存帧指针寄存器的值后,此时%rsp处于16位对齐状态。所以接下来栈指针移动分配的空间都将是16的倍数。其中,之所以设置帧指针是因为栈指针会随局部变量分配与释放而不断移动,而指向帧的底部的帧指针是固定不动的,使用它来配合偏移量来访问数据是更加简单的。
subq    $16, %rsp
    movq    %fs:40, %rax
    movq    %rax, -8(%rbp)
然后是为i与金丝雀值分配栈空间。long类型的i占据8字节,而金丝雀值也占8字节。为二者开辟的空间恰好为16字节,满足栈指针对齐要求。所以栈直接分配16字节空间。其中,
现代编译器为了简化策略,会保证%rsp的每次sub后都处于16位对齐状态。也就是说如果没有金丝雀值,编译器依旧会给long分配16字节的栈空间
    leaq    22(,%rdi,8), %rax
    andq    $-16, %rax
    subq    %rax, %rsp
    leaq    7(%rsp), %rax
    shrq    $3,%rax
    leaq    0(,%rax,8),%r8
接下来就是给变长数组分配空间.
p的数据类型为long*,占8字节。而长度n存在%rdi中。
那么所需空间为8 * n字节。但编译在此基础上再加上了22,这是一个经验值,用于后面的对齐操作。
andq &-15,%rax其中-16的低八位为1111 0000。说明其就是给%rax的值做mod 16的运算。配合前面的加22.这两条指令合起来的操作就是给8*n向上取整到16的倍数(不包含8*n本身)以使得栈指针对齐同时空间还有余量。如n = 4时分配48字节,n = 5时分配48字节
分配空间后需要确定数组初始位置。由于%rsp可能不满足8字节对齐要求,会将初始位置从%rsp向上取整至8的倍数。
后三条指令就是干这个事,通过运算X_p = ((%rsp + 7) / 8) * 8来得到p的起始位置。如%rsp = 0x108时,得到的内存地址为0x108不变。